تمام نوشتههای برچسبخورده با "مدلهای زبانی بزرگ"
یک تحقیق مشترک جدید توسط SentinelOne SentinelLABS و Censys نشان داده است که استقرار هوش مصنوعی (AI) متنباز یک "لایه گسترده مدیریتنشده و در دسترس عموم از زیرساخت محاسباتی هوش مصنوعی" ایجاد کرده است که ۱۷۵,۰۰۰ میزبان منحصربهفرد Ollama را در ۱۳۰ کشور در بر میگیرد. این سیستمها که هم شبکههای ابری و هم شبکههای مسکونی را در سراسر جهان پوشش میدهند، خارج از کنترل عادی عمل میکنند.
مدلهای زبانی بزرگ نامحدود مانند WormGPT 4 و KawaiiGPT قابلیتهای خود را برای تولید کد مخرب بهبود میبخشند و اسکریپتهای کاربردی برای رمزگذارهای باجافزار و حرکت جانبی ارائه میدهند
گروه اطلاعات تهدید گوگل (GTIG) تغییر عمدهای را در امسال شناسایی کرده است که در آن مهاجمان از هوش مصنوعی برای استقرار خانوادههای جدید بدافزار که مدلهای زبانی بزرگ (LLM) را در حین اجرا ادغام میکنند، استفاده میکنند.
مایکروسافت به کمپین فیشینگ جدیدی اشاره میکند که عمدتاً سازمانهای مستقر در آمریکا را هدف قرار داده و احتمالاً از کدهای تولید شده توسط مدلهای زبانی بزرگ (LLM) برای مبهمسازی بارهای مخرب و فرار از دفاعهای امنیتی استفاده کرده است.

 101
محققان امنیت سایبری توجه را به روش جدید جیلبریک به نام اتاق پژواک جلب میکنند که میتواند برای فریب مدلهای زبانی بزرگ محبوب جهت تولید پاسخهای نامطلوب، صرفنظر از محافظتهای اعمال شده، مورد استفاده قرار گیرد.
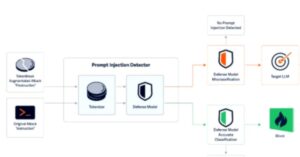
محققان امنیت سایبری تکنیک حمله جدیدی به نام TokenBreak را کشف کردهاند که میتواند با تغییر تنها یک کاراکتر، از محافظهای ایمنی و نظارت محتوای مدلهای زبانی بزرگ (LLM) عبور کند. حمله TokenBreak استراتژی توکنسازی مدل طبقهبندی متن را هدف قرار میدهد تا نتایج منفی کاذب ایجاد کند و اهداف نهایی را در برابر حملاتی آسیبپذیر بگذارد که سیستم پیادهسازی شده
محققان امنیت سایبری تکنیک حمله جدیدی به نام TokenBreak کشف کردهاند که میتواند با تنها یک تغییر کاراکتر، حفاظهای ایمنی و نظارت محتوای مدلهای زبانی بزرگ (LLM) را دور بزند.
مجموعه دادهای که برای آموزش مدلهای زبانی بزرگ (LLM) استفاده میشود، حاوی نزدیک به ۱۲,۰۰۰ اطلاعات محرمانه فعال است که امکان احراز هویت موفق را فراهم میکند. این یافتهها بار دیگر نشان میدهد که اعتبارنامههای کدگذاری شده خطر امنیتی جدی برای کاربران و سازمانها محسوب میشوند.